Explorée, actuellement non indexée : pourquoi Google écarte ta page
Explorée, actuellement non indexée : ce statut de la Search Console veut dire que Google a lu ta page, puis ne l'a pas mise dans son index. Elle ne sort donc pas dans ses résultats. Google ne dit pas pourquoi, page par page. Ses aides donnent des pistes : contenu de faible qualité, doublon, page mal reliée. Et parfois, il suffit d'attendre.
 Par Jérémy Santos Mis à jour le 30 octobre 2026 Testé sur son propre compte SemChat : premier audit le 29 octobre 2026.
Cette page fait partie du guide : Search Console, c'est quoi
Google est passé sur ta page, mais l’a laissée de côté. Illustration Zéro Corvée.
Tu ouvres ta Search Console et tu vois une page marquée « explorée, actuellement non indexée ». Google est passé, il a lu, et il est reparti sans la ranger. Ce guide fait partie de notre dossier Search Console, c’est quoi : il t’explique ce statut, ses causes possibles, quoi corriger et quand ne rien toucher. Il s’appuie sur les aides officielles de Google, lues le 30/10/2026, et sur un test réel de SemChat. Les boutons SemChat de cette page sont des liens affiliés.
Ce que veut dire « explorée, actuellement non indexée »
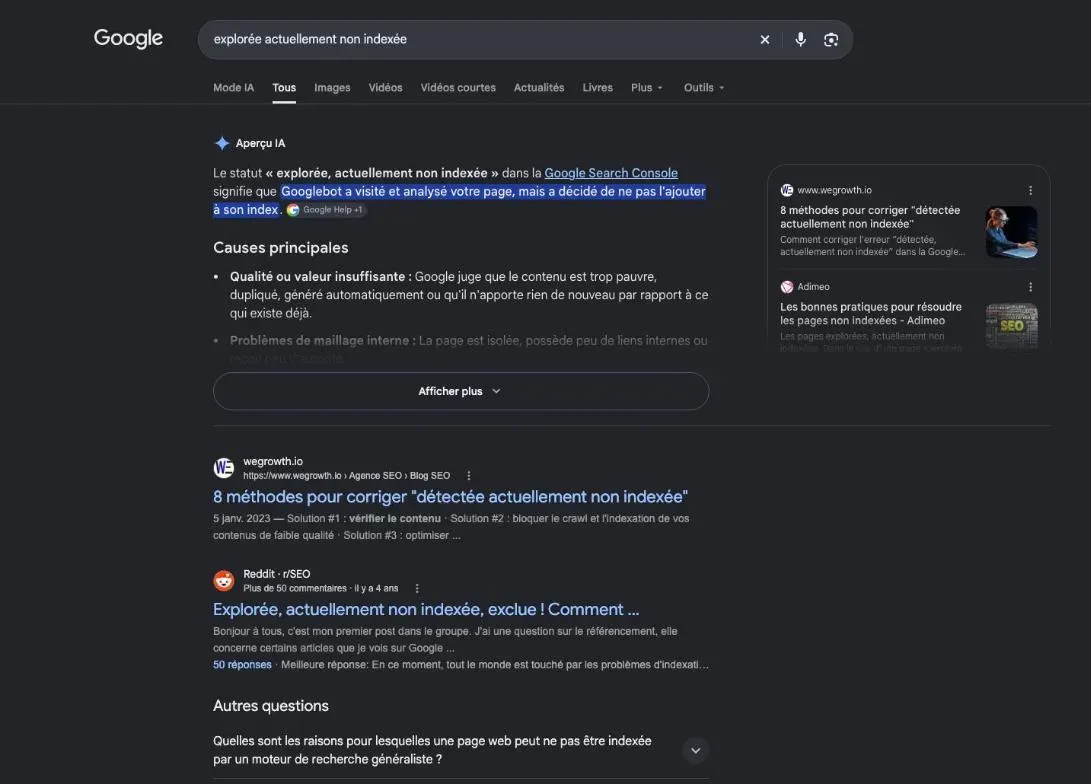
L’aide de la Search Console donne une définition courte : « La page a été explorée par Google, mais pas indexée. Elle sera peut-être indexée à l’avenir ; il n’est pas nécessaire de renvoyer cette URL pour l’exploration. »
Trois choses à retenir de cette phrase :
- Google a bien lu ta page. Elle n’est ni introuvable ni bloquée.
- Il ne l’a pas ajoutée à son index. Elle ne peut donc pas sortir dans ses résultats.
- Rien n’est définitif. La page « sera peut-être indexée à l’avenir », et Google dit qu’il est inutile de la lui renvoyer.
Si ta Search Console est en anglais, le même statut s’appelle « Crawled - currently not indexed » (explorée, actuellement non indexée). Il se lit dans le rapport sur l’indexation des pages, dans la liste des raisons de non-indexation.
Page non indexée : explorée ou détectée, la différence
Une page non indexée peut porter deux statuts voisins, qu’on confond souvent. Google définit le second ainsi : « La page a été détectée par Google, mais n’a pas encore été explorée. En règle générale, cela signifie que Google voulait explorer l’URL, mais que l’exploration a été reportée, car votre site risquait d’être surchargé. »
La différence tient en une question : Google a-t-il lu la page ?
| Détectée, actuellement non indexée | Explorée, actuellement non indexée | |
|---|---|---|
| Google connaît l'adresse | oui | oui |
| Google a lu la page | pas encore | oui |
| Ce que dit l'aide | exploration reportée pour ne pas surcharger ton site | peut-être indexée plus tard, inutile de la renvoyer |
Pour une page détectée, la question porte surtout sur l’exploration. Pour une page explorée, Google a vu ton contenu : c’est donc lui, ou la place de la page dans ton site, qu’il faut regarder en premier.
Découverte, exploration, indexation : où ta page s’est arrêtée
Google décrit son travail en trois étapes, et précise que toutes les pages ne les franchissent pas :
- L’exploration. Google trouve l’adresse, par un lien depuis une page qu’il connaît ou par un sitemap, puis son robot télécharge la page.
- L’indexation. Google analyse le texte, les images et les vidéos, puis range les informations dans son index, « une grande base de données ».
- La diffusion. Quand quelqu’un cherche, Google puise dans cet index pour afficher ses résultats.
Une page explorée mais non indexée s’est donc arrêtée entre la première et la deuxième étape. Google l’écrit sans détour : « L’indexation n’est pas garantie. Toutes les pages que Google traite ne sont pas indexées » (guide détaillé de la recherche Google, lu le 30/10/2026). Pour le fonctionnement complet, lis notre page sur l’indexation Google.
Repérer les pages concernées dans la Search Console
Avant de corriger, il faut savoir quelles pages sont touchées, et si elles comptent vraiment pour toi.
Le rapport « Indexation des pages »
Ouvre la Search Console, puis le rapport sur l’indexation des pages. Sous le graphique, le tableau « Pourquoi des pages ne sont pas indexées » liste les raisons. Clique sur la ligne « Explorée, actuellement non indexée » : tu obtiens la liste des adresses touchées.
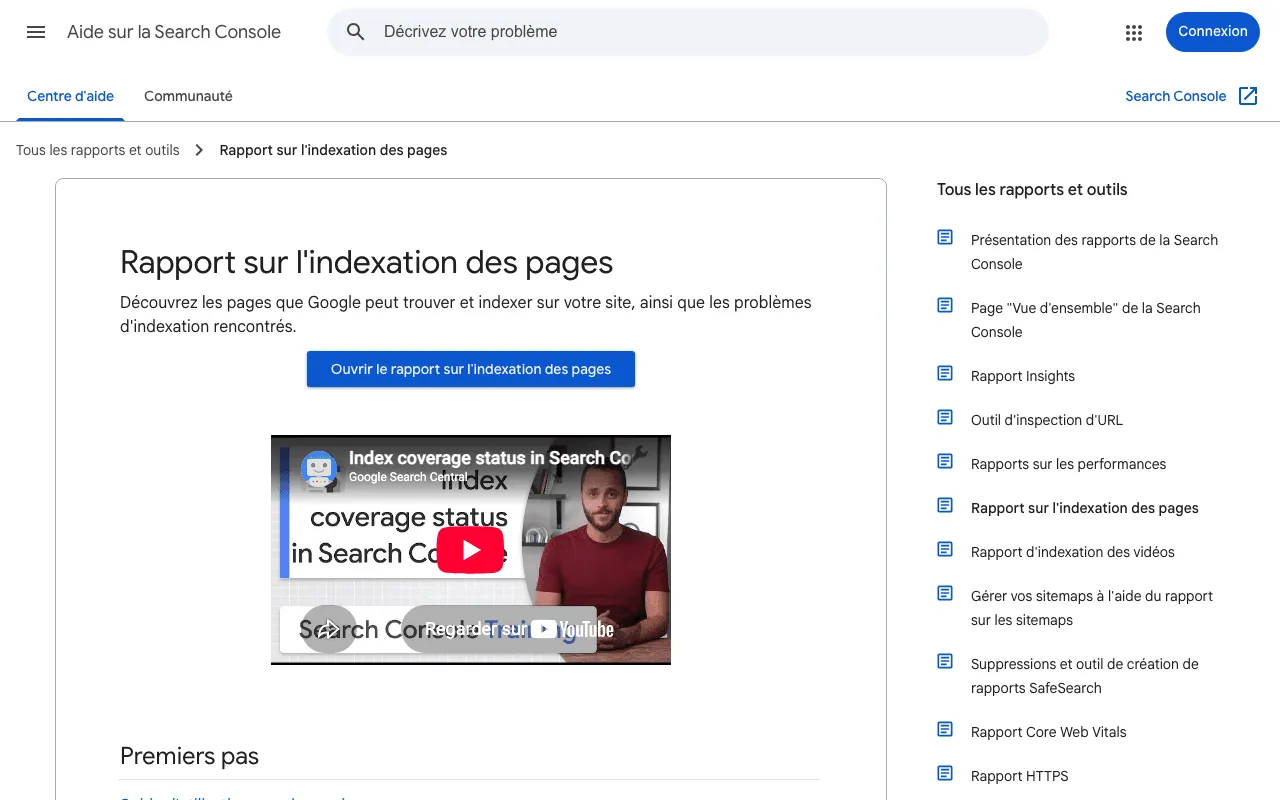
Deux précisions de Google sur ce rapport :
- La liste d’exemples s’arrête à 1 000 adresses, et il n’est pas garanti que toutes les adresses d’un statut y figurent.
- La colonne « Source » dit d’où vient le problème. En général, tu ne peux corriger que ceux dont la source est « Site Web ».
Et un conseil qui concerne beaucoup de petits sites : « Si votre site comporte moins de 500 pages, ce rapport ne vous sera probablement d’aucune utilité. » Google propose alors de vérifier tes pages clés avec une recherche, comme expliqué plus bas.
L’inspection d’URL, page par page
Le rapport ne se filtre pas par adresse. Pour une page précise, Google renvoie vers l’outil d’inspection d’URL, qui « fournit des informations sur la version indexée par Google d’une page spécifique » et permet de vérifier si une URL peut être indexée.
Colle l’adresse de ta page dans la barre du haut de la Search Console. Tu vois son statut, la date de dernière exploration et, avec « Tester l’URL active », ce que Google voit aujourd’hui. Commence par ta page d’accueil et tes pages qui rapportent : ce sont elles qui doivent être indexées.
Le contrôle à la main avec la commande site:
Sans ouvrir la Search Console, tu peux vérifier dans Google lui-même. L’aide propose trois recherches :
site:tondomaine.fr: un échantillon des pages que Google connaît ;site:tondomaine.fr mot1 mot2: les pages qui parlent d’un sujet ;site:suivi de l’adresse exacte d’une page : pour voir si cette page est indexée.
Si la page ne sort pas, l’inspection d’URL te dira pourquoi. Si elle sort, elle est indexée, même si elle n’apparaît pas sur tes recherches habituelles : Google rappelle que les résultats changent selon l’historique, le lieu et bien d’autres variables.
La cause que Google cite en premier : un contenu jugé peu utile
Google ne publie pas de classement des causes de ce statut. Mais dans son guide de la recherche, la liste des « problèmes courants d’indexation » commence par celui-ci : « Le contenu de la page est de faible qualité ». Les deux autres sont les règles meta robots qui interdisent l’indexation, et une conception de site qui rend l’indexation difficile.
Le contenu interchangeable, que d’autres pages disent déjà
Google a lu ta page. S’il ne la garde pas, demande-toi ce qu’elle apporte de plus que les autres. Sa page sur les contenus utiles pose des questions simples :
- « Votre contenu fournit-il des informations, des rapports ou des travaux de recherche ou d’analyse véritablement originaux ? »
- « Si votre contenu s’appuie sur d’autres sources, l’avez-vous simplement recopié ou reformulé, ou y avez-vous apporté de la valeur ajoutée et une touche d’originalité ? »
- « Le contenu offre-t-il des informations plus pertinentes que les autres pages dans les résultats de recherche ? »
Une fiche produit qui reprend le texte du fabricant, un article qui résume ce que dix autres disent déjà, une page de catégorie sans texte : ces pages répondent mal à ces questions.
Les pages produites en masse avec l’IA
Google a une règle précise pour les pages créées en grand nombre. Il parle d’« utilisation abusive de contenus à grande échelle » quand on génère « de nombreuses pages dans le but principal de manipuler le classement dans la recherche Google et non d’aider les utilisateurs ».
Parmi ses exemples : l’« utilisation d’outils d’IA générative ou d’autres outils similaires pour générer de nombreuses pages sans ajouter de valeur pour les utilisateurs ». L’outil n’est pas le problème : Google vise ces contenus « quelle que soit la façon dont ils sont créés ». Ce qui compte, c’est la valeur pour ton lecteur.
Un signal qui dépasse la page : la qualité de tout le site
Beaucoup de guides disent qu’un site rempli de pages faibles voit ses bonnes pages moins bien traitées. Les aides de Google que j’ai lues ne le disent pas en ces mots pour ce statut. Deux phrases vont toutefois dans ce sens :
- pour les contenus produits en masse sans valeur, la consigne est nette : « Si vous hébergez un tel contenu sur votre site, excluez-le de la Recherche » ;
- le rapport d’indexation rappelle que certaines adresses ne sont pas indexées « parce qu’elles ne contiennent pas d’informations significatives ».
Ma lecture, à prendre comme telle : moins tu publies de pages vides, plus ton site est simple à comprendre pour Google.
Les autres causes : doublons, maillage, blocages techniques
Le contenu n’explique pas tout. Trois autres pistes reviennent dans les aides de Google.
Des pages en double ou presque sur ton site
Pendant l’indexation, Google regroupe les pages au contenu similaire et choisit la plus représentative : la page « canonique ». Les autres restent des versions alternatives. Son rapport le dit clairement : « les URL en double ne doivent pas être indexées ».
Exemples courants sur une boutique : la même fiche produit accessible par deux catégories, des pages de filtres (taille, couleur) presque identiques, une page imprimable. Quand Google repère un doublon, le rapport a des lignes à part, comme « Page en double sans URL canonique sélectionnée par l’utilisateur ». Pour une page précise, l’inspection d’URL compare l’« URL canonique déclarée par l’utilisateur » et l’« URL canonique sélectionnée par Google » : si Google a choisi une autre page que la tienne, tu tiens ta piste.
Une page mal reliée au reste du site
Google trouve tes pages par les liens. Son aide est explicite : une page « doit être référencée sur une page connue ou un sitemap ». Elle ajoute : « Si la navigation de vos pages a été bien pensée, Google devrait être en mesure de toutes les indexer à partir de votre page d’accueil. »
Google peut trouver une page par ton sitemap seul. Ma lecture : si aucune de tes pages ne la met en avant, rien ne lui dit qu’elle compte pour toi.
Un blocage technique qui gêne l’exploration
Les blocages nets ont leur propre ligne dans le rapport : « URL bloquée par le fichier robots.txt », « URL marquée “noindex” », « Erreur serveur (5xx) », « Introuvable (404) », « Erreur “soft 404” ». Une page bloquée ne tombe donc pas, en principe, dans « explorée, actuellement non indexée ».
Restent les problèmes plus discrets. Google cite, parmi les problèmes courants d’indexation, une conception de site qui « rend difficile l’indexation », sans détailler. Pour voir si c’est ton cas, l’inspection d’URL montre une capture de la page « telle que Google-InspectionTool la voit », ses ressources chargées et la sortie JavaScript. Si ton texte n’apparaît pas sur cette capture, Google ne le voit pas non plus.
Site non indexé par Google : quand tout le site manque
Si aucune page ne sort avec la commande site:, le problème est plus large. Google donne deux raisons fréquentes :
- Le site est nouveau. « Il faut jusqu’à une semaine pour que Google commence à explorer et à indexer une nouvelle page ou un nouveau site. »
- Google ne trouve pas les pages. Pour un nouveau site, la première étape est de demander l’indexation de ta page d’accueil.
La marche à suivre complète est sur notre page pour indexer son site sur Google.
Un exemple réel : les titres en double relevés sur plugkit-avis.com
Je teste mes outils sur mes propres sites. Le 29/10/2026, j’ai demandé à SemChat, en une phrase, un audit SEO de plugkit-avis.com, un de mes sites, publié en plusieurs langues. Parmi ses chiffres clés : des titres en double sur 100 pages (53 %) et des grands titres (H1) en double sur 102 pages (54 %).
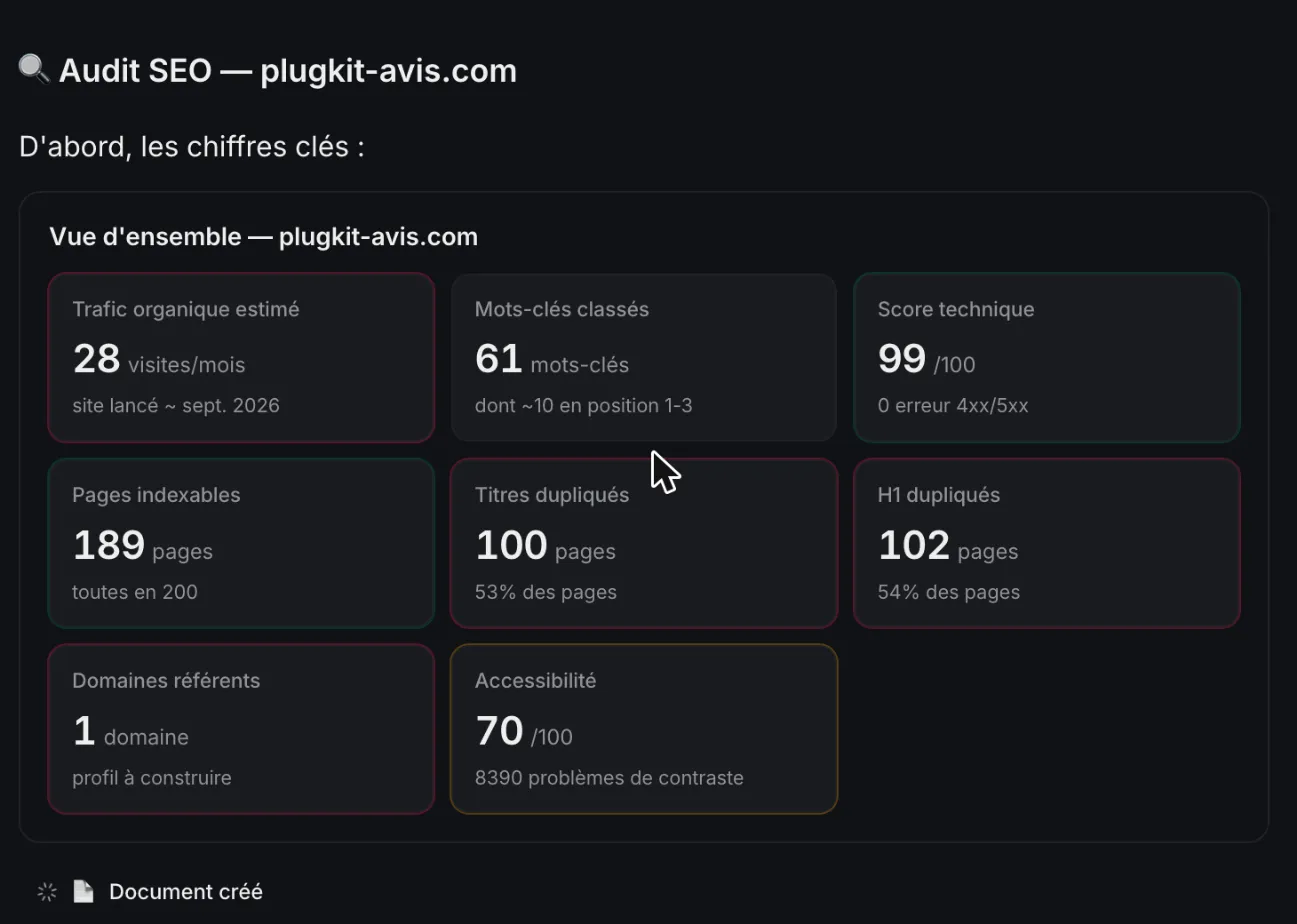
J’ai vérifié. Le constat est exact : par exemple, la page anglaise américaine et la page anglaise britannique d’un même avis ont le même titre. Mais ce sont des variantes régionales déclarées comme telles à Google (balises hreflang). Un doublon voulu et signalé, donc, pas un copier-coller oublié.
Le même jour, j’ai lancé un audit centré sur l’indexation, appuyé sur ma Search Console. SemChat a inspecté 5 pages : les 5 étaient indexées. Son premier diagnostic était pourtant faux. Il voyait « ~70 pages anglaises, 0 impression » et envisageait de les passer en noindex, alors qu’une de ces pages avait environ 27 à 30 impressions. Il présentait aussi les 104 H1 en double comme du « contenu générique ».
Relancé avec ces points, il a répondu : « J’avais tort sur trois points ». Son diagnostic corrigé range les pages en trois cas : bloquées par toi, connues mais pas retenues, trop récentes. Les 104 H1 deviennent 52 paires de pages en anglais américain et britannique.
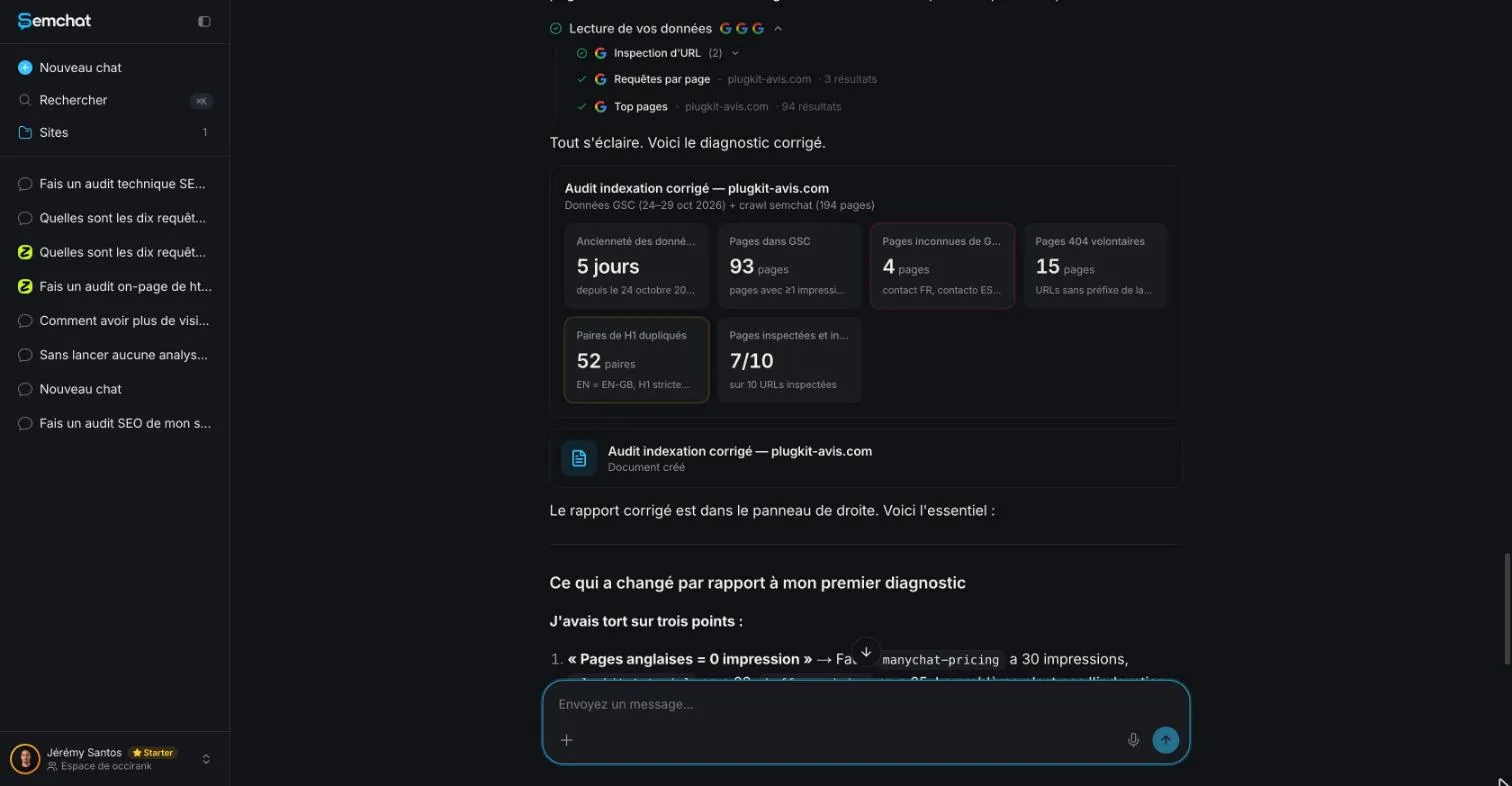
Ce que dit la Search Console, elle : 10 pages inspectées « Submitted and indexed » (envoyées et indexées), et 2 pages « URL is unknown to Google » (adresse inconnue de Google), /fr/contact/ et /pt-br/contato/, alors qu’elles sont dans les sitemaps. SemChat avait bien trouvé ces deux pages inconnues. En revanche, les trois actions qu’il proposait à la fin étaient fausses : ajouter au sitemap une page qui y était déjà, ajouter deux pages qui répondent en 404, créer un sitemap qui existait.
Ma conclusion : des titres en double sont une cause possible à vérifier, pas une preuve. Sur ce site, les pages inspectées étaient indexées malgré eux. Un outil te fait gagner du temps pour repérer les pistes ; la Search Console reste le juge.
Que corriger, dans l’ordre
Voici l’ordre que je suis. Il va du plus utile au plus accessoire.
- 1 Améliorer la page Ajoute ce que les autres pages ne disent pas.
- 2 La relier Des liens depuis tes pages fortes.
- 3 Lever les blocages Canonique, noindex, rendu de la page.
- 4 Sitemap propre Seulement les pages à indexer.
- 5 Demander l'indexation Une fois, après un vrai changement.
Améliorer le contenu de la page
Reprends les questions de Google sur les contenus utiles. Ajoute ce que toi seul peux dire : ton expérience, tes photos, tes prix, un exemple réel, une réponse précise à la question de ton client. Si la page n’a rien à ajouter, demande-toi si elle doit exister.
Relier la page à tes autres pages
Ajoute des liens vers elle depuis des pages que Google connaît déjà et qui sont indexées : ta page d’accueil, une page de catégorie, un article proche. Utilise comme texte de lien les mots qui décrivent la page, pas « cliquez ici ».
Corriger les erreurs techniques
Inspecte l’URL, puis teste l’URL active. Vérifie trois choses : que la capture montre bien ton texte, que l’URL canonique choisie par Google est la tienne, et qu’aucune règle noindex oubliée ne traîne sur la page.
Envoyer un sitemap propre et à jour
Ton sitemap doit lister les pages que tu veux voir indexées, et elles seules. Google conseille, pour beaucoup de pages nouvelles ou mises à jour, d’envoyer un sitemap où ces pages portent la balise <lastmod>. Pour comprendre ce fichier, lis notre page sitemap, c’est quoi.
Sur une plate-forme hébergée comme WordPress ou Blogger, l’aide de Google note que « dans la plupart des cas, la plate-forme envoie automatiquement votre nouveau contenu aux moteurs de recherche ».
Demander une nouvelle indexation
Une fois la page vraiment améliorée, tu peux demander une indexation dans l’outil d’inspection d’URL. Google pose trois limites :
- il faut être « un propriétaire ou un utilisateur avec accès complet » à la propriété Search Console ;
- « un quota limite l’envoi d’URL individuelles et […] les demandes répétées de réexploration pour une même URL n’accélèrent pas l’exploration » ;
- la demande ne garantit rien : l’inclusion dans les résultats peut ne pas avoir lieu « du tout ».
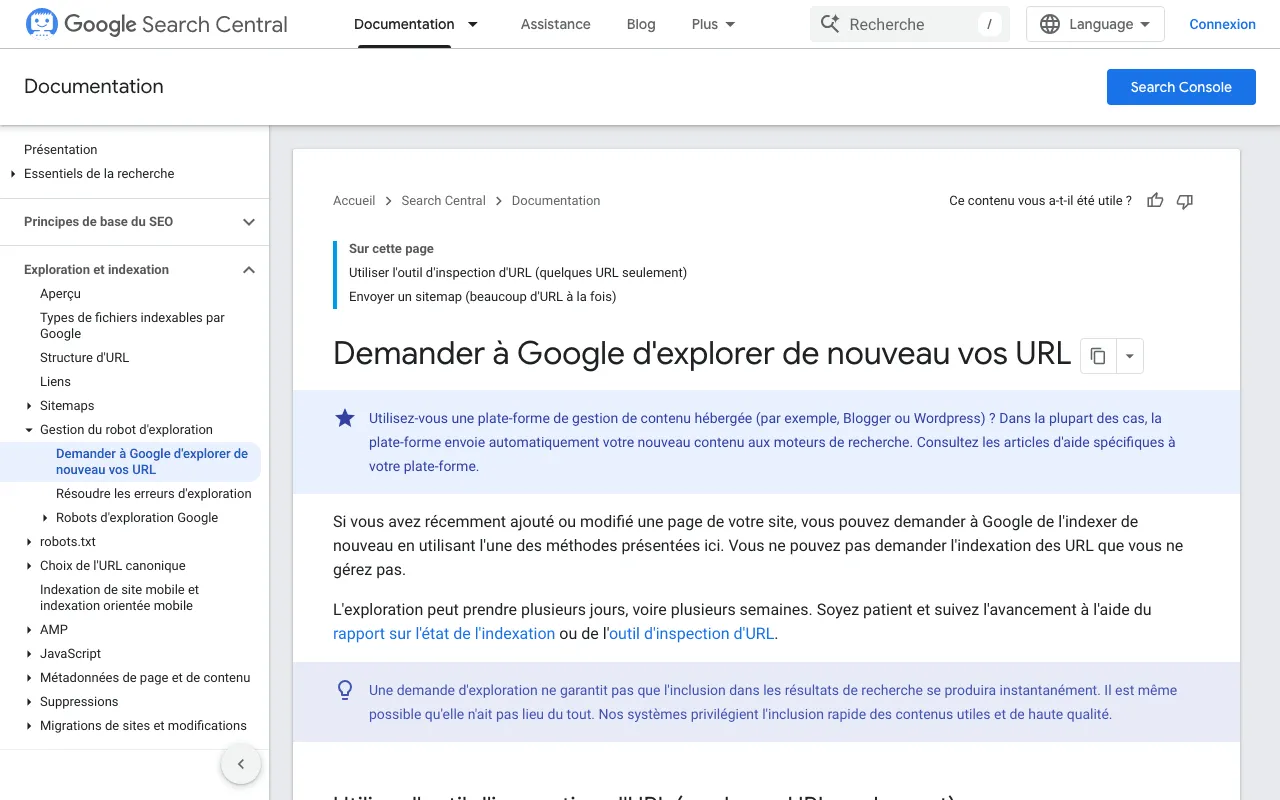
Pour ce statut précis, souviens-toi de la définition : « il n’est pas nécessaire de renvoyer cette URL pour l’exploration ». Renvoyer la même page sans l’avoir changée n’accélère rien : Google le dit des demandes répétées. Renvoie-la après un vrai changement, une seule fois.
Quand attendre sans rien toucher
Toutes les pages non indexées ne sont pas un problème. Google le répète dans son aide : l’état « Non indexée » n’est pas un problème en soi.
Les pages sans valeur, à laisser hors de l’index
Une page de remerciement après un achat, une page de panier, une page d’étiquette de blog avec deux articles : leur absence de l’index n’a rien d’inquiétant. Google le dit : « Ne vous attendez pas à ce que toutes les URL de votre site soient indexées. […] Assurez-vous simplement que les pages clés de votre site sont indexées. »
Une part de pages non indexées, c’est normal
« La plupart des sites comportent au moins quelques pages non indexées, mais toutes vos pages importantes doivent l’être », écrit Google. Il ne donne aucun seuil chiffré, et je n’en invente pas. La bonne question n’est pas « combien », mais « lesquelles ». Si tes pages qui vendent sont indexées, le reste peut attendre.
Une page récente : laisser le temps faire
Google prévient : « L’exploration peut prendre plusieurs jours, voire plusieurs semaines. » Et aussi : « Une demande d’exploration ne garantit pas que l’inclusion dans les résultats de recherche se produira instantanément. »
Dans mon test, plugkit-avis.com n’avait que 5 jours de données dans la Search Console le 29/10/2026. Juger l’indexation de dizaines de pages sur 5 jours, c’était trop tôt : SemChat l’a reconnu lui-même dans sa correction. Pour apprendre à mener ce diagnostic et à relancer l’outil avec les faits, suis la formation gratuite SemChat.
Exclue par la balise noindex : quand la non-indexation est voulue
Parfois, c’est toi qui ne veux pas d’une page dans Google. L’outil prévu est la règle noindex : une balise meta dans le code de la page, ou un en-tête HTTP. Lors de la prochaine exploration, écrit Google, il « exclura totalement la page concernée de ses résultats de recherche, même si d’autres sites contiennent des liens vers celle-ci ».
Deux pièges :
- Ne bloque pas la page dans le fichier robots.txt en plus. Google doit pouvoir lire la page pour voir la règle. Si robots.txt la bloque, la règle n’est pas vue et la page peut rester dans les résultats.
- Ne pose pas de noindex sur la foi d’un diagnostic non vérifié. Dans mon test, le premier diagnostic de SemChat envisageait un noindex sur des pages qui avaient des impressions.
Sous WordPress ou Wix, tu n’as pas besoin de toucher au code : Google indique que ton CMS peut avoir une page de réglages pour les moteurs de recherche.
Surveiller pour que le problème ne revienne pas
Un coup d’œil au rapport d’indexation chaque mois
Google donne le repère : « Si tout va bien, le nombre de pages indexées devrait augmenter à mesure que votre site prend de l’ampleur. » Pour un petit site, je regarde une fois par mois la courbe et la ligne « Explorée, actuellement non indexée ». Une chute ou une hausse forte mérite une enquête : le rapport a une section de dépannage pour ça.
L’indexation n’est qu’un maillon. Pour savoir si tes pages indexées attirent des visiteurs, regarde notre page pour analyser le trafic d’un site web, et celle qui explique Google Analytics, c’est quoi.
Vérifier chaque nouvelle page après publication
Après chaque publication importante, inspecte l’adresse dans la Search Console quelques jours plus tard. Si la page est explorée mais non indexée, repasse la liste de ce guide : contenu, liens, technique, sitemap, puis une seule demande d’indexation.
Une page explorée, actuellement non indexée n’est pas une sanction. C’est Google qui te dit qu’il a lu ta page sans la juger assez utile pour l’instant. Rends-la meilleure, relie-la, puis laisse-lui le temps.
Questions fréquentes
Peut-on forcer Google à indexer une page ?
Non. Tu peux demander une indexation dans l'outil d'inspection d'URL, mais Google écrit qu'une demande d'exploration « ne garantit pas que l'inclusion dans les résultats de recherche se produira instantanément. Il est même possible qu'elle n'ait pas lieu du tout ». Un quota limite les demandes, et les répéter pour une même adresse n'accélère rien (aide lue le 30/10/2026).
Comment demander aux moteurs de ne pas indexer ton site ?
Avec la règle noindex, posée en balise meta dans le code de chaque page ou en en-tête HTTP. Google précise que la page ne doit pas être bloquée par le fichier robots.txt : sinon son robot ne voit jamais la règle, et la page peut rester dans les résultats. Sous WordPress ou Wix, un réglage du CMS peut poser la balise pour toi (documentation lue le 30/10/2026).
C'est quoi, l'indexation d'un site ?
Google la décrit ainsi : il explore ta page, la traite, puis l'ajoute à son index, la base de données d'où sortent ses résultats. Sans indexation, une page n'apparaît pas dans la recherche Google. Google prévient aussi que l'indexation n'est pas garantie : toutes les pages qu'il traite ne sont pas indexées (aides lues le 30/10/2026).
Quelle différence entre « explorée » et « détectée, actuellement non indexée » ?
Détectée : Google connaît l'adresse mais n'a pas encore lu la page, en général parce qu'il a reporté l'exploration pour ne pas surcharger ton site. Explorée : Google a lu la page et ne l'a pas retenue pour l'instant. Pour ce second statut, son aide dit qu'il n'est pas nécessaire de renvoyer l'adresse (rapport sur l'indexation des pages, lu le 30/10/2026).
Laisse ton IA faire les corvées de ta visibilité en ligne.
-10 % à vie sur ton abonnement avec mon lien, si tu t'abonnes dans les 2 semaines après ton inscription. Sans code. Tout sur le code promo SemChat
Lien affilié : ça ne te coûte rien de plus.
Sources vérifiées
- Aide Search Console : rapport sur l'indexation des pages (30/10/2026)
- Aide Search Console : outil d'inspection d'URL (30/10/2026)
- Google Search Central : demander à Google d'explorer de nouveau vos URL (30/10/2026)
- Google Search Central : guide détaillé de la recherche Google (30/10/2026)
- Google Search Central : créer des contenus utiles, fiables et people-first (30/10/2026)
- Google Search Central : règles concernant le spam dans la recherche sur le Web Google (30/10/2026)
- Google Search Central : bloquer l'indexation dans la recherche avec noindex (30/10/2026)
- Tarifs de SemChat (plan Free, plan Starter) (29/10/2026)